英特尔现已为最新发布的MiniMax H3-Image提供Day 0适配和支持。针对超高分辨率图像生成带来的新要求,通过英特尔锐炫™ Pro B70多卡协同、并行计算与软件优化,充分调动多卡GPU的潜力,让MiniMax H3-Image在发布之初,即可获得软硬件层面的适配与加速,助力开发者更轻松、更高效地释放大模型的创作潜力。
基于英特尔锐炫Pro B70 多卡方案的MiniMax H3-Image生成效果图
MiniMax H3-Image是一款面向多元创作场景的图像生成与编辑模型,它支持最多16张参考图,可高效完成复杂图像生成与编辑任务。凭借在游戏素材、3D视觉内容等方面的表现,该模型还可广泛应用于电商、广告创意、AI智能体及生产力工具等场景,为视觉创作带来更多可能。
Day 0加速的硬件底座,是由8张英特尔锐炫Pro B70 GPU打造的英特尔锐炫多卡解决方案。作为方案的核心,锐炫Pro B70 配备了高达32GB 的大容量显存,同时提供608 GB/s的显存带宽,以及367 TOPS 的峰值INT8 AI计算能力。
凭借多卡协同带来的性能提升和灵活扩展能力,锐炫多卡解决方案突破了单卡在显存容量与计算资源上的限制,不仅能为更大规模模型以及更复杂的AI工作负载提供灵活、可扩展的算力支持,还能降低AI部署的成本与复杂度,以更出色的成本效益提供相似的性能支持。
在该方案中,文本编码器与 DiT 主干采用8路张量并行(8TP),VAE采用8卡图块并行解码,实现6272×2688超高分辨率图像在六步生成下的全流程 GPU 加速。目前,相关并行方案与算子优化已在 SGLang Diffusion上完成适配。
整个过程中,文本编码器、DiT、VAE分时复用8卡GPU资源。具体而言,文本编码器以张量并行方式运行。作为计算量最大的模块,DiT将参数与计算按张量维度切分至8张锐炫GPU之中,单卡仅承载约八分之一的权重与负载,显著降低显存占用并支撑更大规模的模型。VAE则采用8卡图块并行,将完整图块分发至各卡并行解码后汇总结果,权重在各卡保留副本,无需切分卷积权重,仅在图块边界处拼接。通过统一的8卡部署,该方案在降低单卡显存压力、支撑更大规模模型的同时,进一步提升多卡协同计算效率。
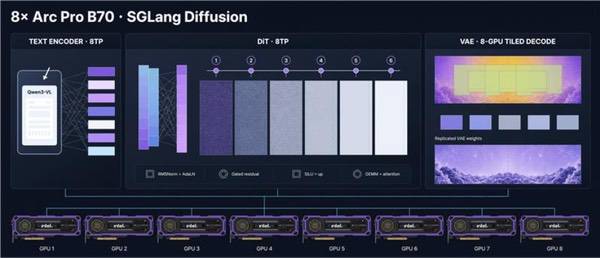
英特尔锐炫Pro B70 多卡方案演示
英特尔还在该框架的XPU Kernel路径上进行了系统性优化,围绕DiT主干的高频计算链推进算子融合与调度改进,覆盖归一化与索引化调制、门控残差、激活与逐元素乘等环节,并持续优化矩阵乘法与注意力路径。其中,融合后的RMSNorm与索引化AdaLN相较原始PyTorch算子链取得数倍加速,门控残差与SiLU×up亦有可观提升1。上述优化使去噪阶段与端到端时延均明显下降,并在提速的同时保持了数值稳定,为后续优化留出了空间。
后续我们将依托H3-Image 16MP 基线画质,产出细节更丰富的人物和场景资产,并搭配面向英特尔平台深度优化的MiniMax H3生视频模型。整套本地方案集成流式显存调度、适配英特尔硬件的模型定制协同设计,单张英特尔锐炫Pro B70即可实现媲美云端画质的视频生成。配合自研本地生视频 Agent,还可在本地链路闭环完成镜头拆分、视频生成、编辑与修复,一站式支撑短剧内容生产。
要让硬件性能真正转化为开发者触手可及的生产力,软件优化同样不可或缺。英特尔提供覆盖模型适配、优化到部署全流程的 AI 软件栈,支持 PyTorch、vLLM、SGLang、SGLang Diffusion、ComfyUI 和 OpenVINO,与锐炫 Pro B70 形成软硬件协同。这让开发者能够更充分地释放大模型的生产力,让AI能力真正融入创作流程,为更多创意打开空间。
同时,英特尔也将于近期发布针对MiniMax H3-Image ComfyUI量化版本的软件栈支持,让更多工作室和个人创作者基于锐炫Pro B70单卡就能进行高效创作!
英特尔将持续为国内前沿AI模型提供Day 0支持,并与本地模型厂商、开发者及生态伙伴紧密协作,通过产品与技术创新,让前沿AI能力更快触达用户,带来更加丰富、高效的AI体验。