当一个智能体在几秒钟内完成思考、检索、规划和执行,它的背后往往涉及多次模型调用、海量数据访问以及复杂的资源调度,一场围绕基础设施的演变也随之展开。在2026云栖大会上,英特尔携手阿里云展示了双方在智能体AI领域的最新进展。基于英特尔® 至强® 处理器,双方围绕云实例性能优化、AI存储平台加速、Agentic Browser创新应用以及千问展开合作,共同探索面向智能体时代的新一代基础设施架构。
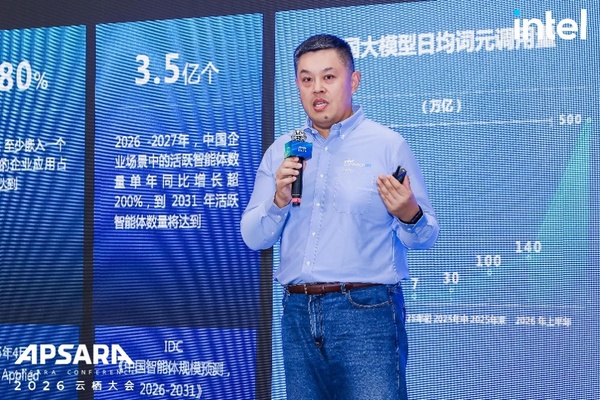
英特尔数据中心集团副总裁、中国区总经理陈葆立发表开场致辞
英特尔数据中心集团副总裁、中国区总经理陈葆立表示:“智能体AI时代,算力是起点,贯穿记忆、调度、执行的系统能力,是决定智能体走多远的关键。凭借强大的算力与内置加速引擎,至强正在为智能体AI提供更敏捷的思考、更持久的记忆、更高效的任务承载和更可靠的执行。我们希望,英特尔和阿里云的携手,既能推动AI速度更快,又能让AI规模化落地,创造真正的价值。”
在云端:从至强的芯片底层,优化智能体的真实运行环境
搭载英特尔至强6处理器的阿里云第九代企业级ECS实例g9i,覆盖智能体全栈算力需求。针对智能体业务形态多变的特点,g9i实现了按智能体真实工作负载形态精准供给算力,打造了涵盖专有硬件AI加速、QAT硬件加速、数据全路径持久化、安全可靠的虾笼、出色的弹性能力和稳定性优化在内的6大技术能力。
英特尔至强6处理器从芯片底层激活了g9i的效能,提供了高密度的核心数、出色的单核性能与内存带宽,同时又在性能与能效曲线上找到了平衡点,成为承载AI智能体复杂工作负载的可靠支撑,帮助g9i性能较上代提升最高达20%,弹性临时盘单盘吞吐最高4GB/s,为更多的行业与客户提供了更强劲、更稳定的云计算服务。
在智能体AI加速落地的今天,硬件之外的开放软件生态也成为决定因素之一。依托开放统一的软件底座,英特尔打通不同架构之间的开发壁垒,让应用迁移和性能优化变得更加简单。通过引入基于大语言模型的AI Agent,并结合面向专业场景的Skill能力,实现高效、高性能的代码原生迁移与优化。从PyTorch、vLLM到SGLang,英特尔持续完善开放软件生态,为开发者提供覆盖模型开发、推理部署和应用落地的完整工具链,让AI应用更快速地落地。
英特尔携手阿里云终端智能,以软硬件协同加速面向海量 Agent 的轻量级云端浏览器落地
在云栖大会现场,英特尔数据中心集团副总裁、中国区总经理陈葆立和阿里云智能集团研发副总裁、终端智能计算事业部负责人张献涛出席 Agentic Browser 合作仪式。阿里云终端智能与英特尔围绕浏览器引擎优化、硬件加速及云端高密度部署展开合作,共同推动 Agentic Browser在智能体场景中的规模化应用。
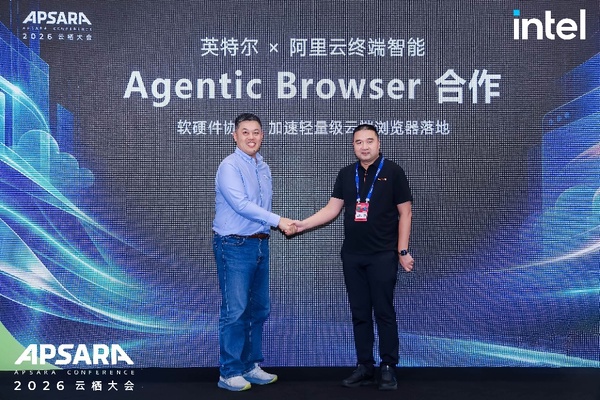
英特尔数据中心集团副总裁、中国区总经理陈葆立,阿里云智能集团研发副总裁、终端智能计算事业部负责人张献涛出席 Agentic Browser合作仪式
针对传统浏览器在海量Agent并发调用时面临的高内存占用问题,双方基于官方Chromium技术体系,对Blink、V8等核心引擎进行轻量化优化,并结合英特尔至强处理器、AVX-512指令集以及IAA、QAT等硬件加速器能力,降低浏览器运行时的内存与CPU开销。联合优化方案可减少约30%的内存开销。
在此基础上,阿里云依托弹性计算和高密度调度能力,将轻量级浏览器部署为面向海量Agent的云端执行集群,并融合Agent与RPA双引擎、Workflow自动沉淀及多层风控机制,提升复杂网页任务的执行效率与稳定性,推动浏览器向低成本、可信赖的智能体云端执行基础设施演进。
软硬协同创新,打造适合智能体时代的存储
智能体AI带来的改变遍布整个AI系统,而存储是最先发生改变的环节之一。其中包括,块存储规模迅速增长,云盘生命周期缩短,工作负载呈现出随机、突发的特征,大量独立存储环境与多样化存储形态随之出现。顺应这一趋势,英特尔与阿里云携手开启新的探索,共同打造基于英特尔至强6处理器的阿里云磐久第九代服务器,为AI基础设施带来低时延、高吞吐、极致弹性和存算解耦的高性能存储能力。
双方围绕AI驱动的块存储场景展开深度软硬件协同优化。针对百万级实例创建启动、百毫秒级任务响应以及基础镜像预热分发等高密度管控面场景,双方在调度、缓存、内存和并发等关键环节持续打磨,通过英特尔睿频加速技术(Turbo Boost)、缓存分配技术(CAT)以及NUMA感知调度等能力,充分释放至强在计算、缓存和内存层级的优势,提升高密度管控场景下的吞吐与响应效率,实现更加高效的数据访问和资源管理,为大规模智能体应用提供敏捷稳定的运行环境。
在与阿里云共同服务智能体工作负载的过程中,英特尔也将这些实践进一步沉淀为面向智能体AI的至强6存储平台。面对智能体对存储容量、性能、能效和部署灵活性提出的更高要求,至强6凭借双路192条PCIe 5.0通道,可支持更高密度的存储部署,结合QAT、DSA等内置加速器,进一步提升数据处理效率。与此同时,UINTR与TPAUSE指令则帮助系统在高性能与高能效之间取得平衡。通过计算、存储与网络的深度协同,至强6帮助客户构建大规模SSD、高性能RDMA网络以及JBOF存储层,借助SPDK打造低延迟、高吞吐的数据通路,为智能体AI提供了高容量、高性能、高能效且易于扩展的存储底座。
在端侧:让千问触手可及
Agent是AI落地的重要场景之一。在端侧场景,推理的核心价值在于保护用户隐私、降低词元成本。对应的打法在于如何解决端侧推理在容量、算力和带宽上所受到的限制。千问通过低比特量化、模型卸载和投机采样,充分发挥英特尔® 酷睿™ Ultra处理器的性能,在端侧设备上实现高效、可靠、低延迟的运行。
在云栖大会上,阿里云宣布正式开源Qwen-Image 2.1,为图像生成和编辑工作提供了更多元化的选择。基于英特尔锐炫™ Pro B70端侧性能的充分释放,Qwen-Image 2.1在图像生成质量、响应速度和部署灵活性之间实现良好平衡。随着越来越多AI能力从云端延伸至终端设备,锐炫Pro B70正帮助开发者将创意生产力带到用户身边。
对于希望将图像生成与视觉内容创作能力部署到本地硬件的开发者和专业创作者而言,Qwen-Image 2.1现已在英特尔平台上获得Day 0支持。凭借原生2K图像输出、RGBA四通道支持以及先进的局部编辑能力,Qwen-Image 2.1以紧凑、高效的70亿参数模型,提供专业级生成式AI体验。
在OpenVINO™工具套件的支持下,Qwen-Image 2.1可运行于英特尔锐炫Pro B70显卡以及英特尔酷睿Ultra 3系列处理器的集成显卡,将专业级图像生成能力带到搭载英特尔平台的AI PC及边缘设备,为本地视觉AI创作提供更加高效、灵活的部署选择。
下一代至强,更强大,更从容
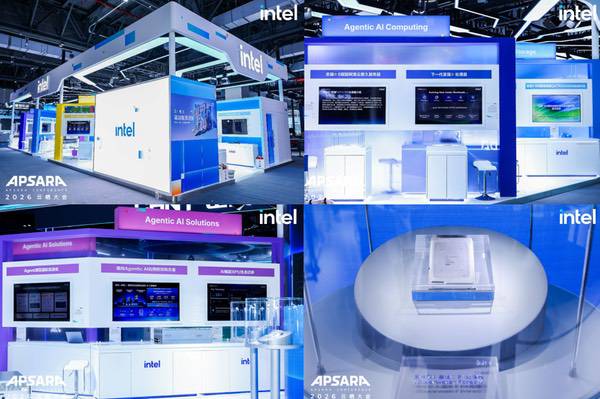
云栖大会英特尔展台
智能体AI来临后,至强在三类AI基础设施中承担不同却同样重要的职责。在GPU集群中,它是稳定而高效的机头CPU。在CPU集群中,它是核心枢纽,承担任务编排、推理调度。在存储集群中,它让海量信息被快速调用和持续记忆。在不同的角色中,至强都表现出了持续进化的能力和英特尔在软件与生态上的积累。
这次,全新的Diamond Rapids在云栖大会亮相,体现的是至强在性能上的继续演化。面对未来更庞大、更复杂的异构Agent工作负载,Diamond Rapids将用更强大的姿态,帮助客户应对Agent场景所提出的各项要求。