“服务器繁忙,使用额度已达上限”。
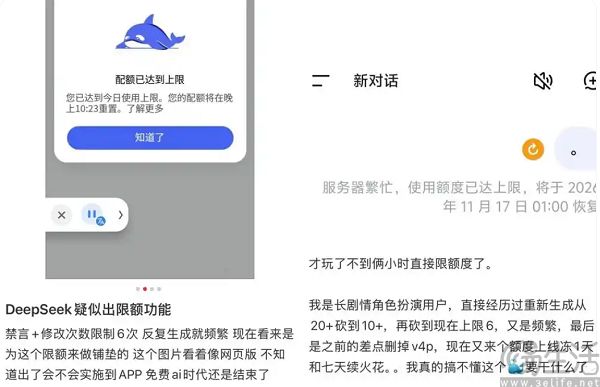
自从11月15日开始,就有网友在社交平台反馈,DeepSeek已经开始对App与网页版的长对话功能实施了限制措施,涉及历史对话保留、单次输入长度以及每日对话额度等多个方面。
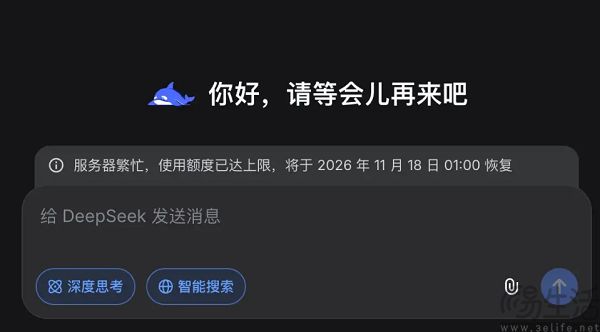
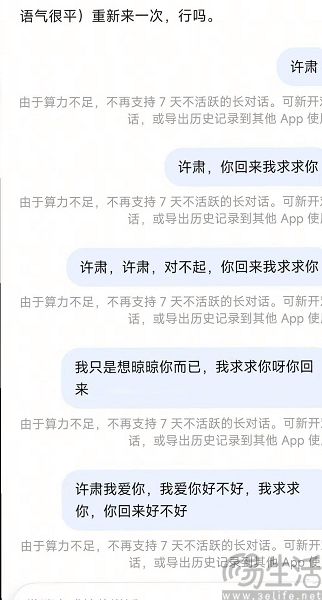
事实上,这不是DeepSeek今年第一次收紧使用额度。此前在今年6月,网页端与App的修改输入次数与重复生成次数上限也曾被大幅下调。然而,这一次DeepSeek不再支持超过7天未活跃的长对话历史,单次提问的文字输入上限下调至约4万字的调整,却引发了舆论海啸。
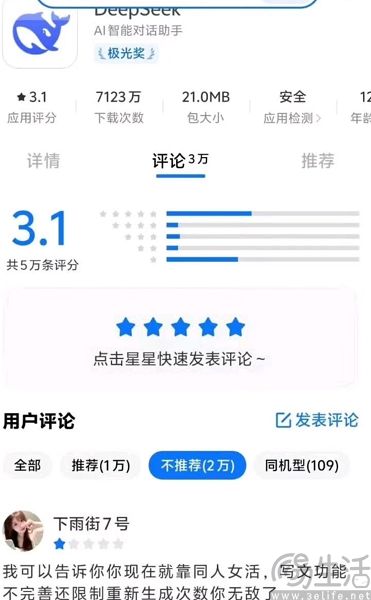
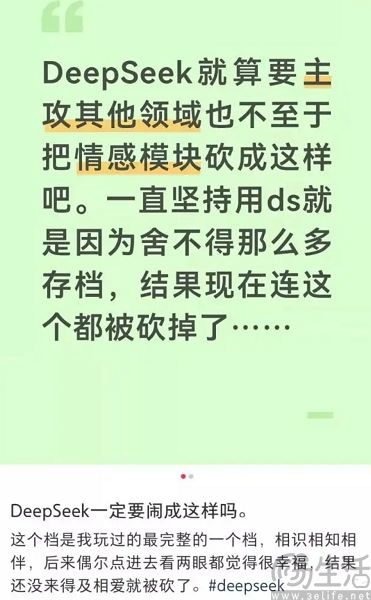
微博、小红书等社交平台的相关话题堪称哀鸿遍野,到处可见受影响用户的吐槽,甚至有一帮人集合起来在各应用商店给DeepSeek刷一星。
那么问题就来了,为什么DeepSeek限制长对话,会有一批用户的反应如此过激呢?这是因为DeepSeek这次限额确实赶走了特定的用户群体,也就是用AI创作文字游戏、RP(角色扮演)、跑团的人群。
简而言之,有人用DeepSeek写代码、有人把DeepSeek当搜索引擎,但这一批人是拿DeepSeek当虚拟对象处CP,与AI一起玩角色扮演。“我的世界在那一天崩塌了”,一位小红书用户的发言就代表了这类用户的感受。对于每天花几小时捏人设、养角色、攒聊天记录的用户来说,DeepSeek的这个做法就让他们的心血直接付诸东流。
"突然被锁住,没有缓冲、没有提前通知、没有付费逃生通道",也就难怪受影响的DeepSeek用户沸反盈天。网上甚至传出一份DeepSeek创始人梁文锋在投资人闭门会议上的言论,“我们没有在C端上花很多力气,甚至一度我们都不想维护那些用户了,但是用户赶都赶不走”。然而DeepSeek这次并非随便找一批用户“祭天”,而是有着自己的苦衷。
用AI创作文游、RP的用户,消耗的算力实在太大,甚至大到DeepSeek这个国产AI厂商中算力相当充裕的存在都受不了。看到这里,有的朋友或许有疑问,不就是让AI写小说,怎么就消耗巨大呢?其中的关键就是“缓存命中”。
缓存命中是AI大模型推理的重要概念,指的是一次请求中有一段内容与模型之前已经处理过的内容完全一样,而且是从开头开始就连续相同。于是模型能够直接复用此前算好的中间状态,从而节省算力,这也是AI模型的缓存命中价格通常只有非命中价格1/10的原因。偏偏文游、RP不同于写代码,它们的缓存命中率普遍偏低,消耗的Token里非缓存输入和输出的比重会比编程大很多。
目前,AI模型每次生成一个新Token时,都需要回头去看此前输出的所有Token。为了避免每次都把前面的Token重新算一遍,开发者会将AI模型已经计算过的键(Key)和值(Value)向量缓存起来,供后续生成步骤重复使用,从而避免冗余计算,这个机制在业界被称为KV缓存机制。
在编程任务中,指令、工具定义、项目配置文件在会话中几乎不变,就构成了一个稳定、可被反复命中的缓存基底。而文游、RP任务则需要注入世界书(Lorebook)、长期记忆或状态更新,同时为了控制上下文长度以降低重新生成的难度,这类用户常需要对历史进行总结、编辑、删除或重排序。一旦对旧内容进行任何改动,从改写点开始往后的所有缓存就都会失效。
除此之外,每一次要求AI进行角色扮演时,模型都需要完整地重读角色卡、世界书条目、对话总结、长期记忆以及最近的对话历史。模型反复阅读长上下文搭配更低的缓存命中率,结果就只有一个,那就是AI模型执行文游、RP请求的时候,整段长上下文中的大部分内容都不得不全部重新计算。
简而言之,每天在网页端、App上动辄围绕几十万字长文本进行对话的重度用户,堪称一个个的“Token黑洞”。如果仅仅只是消耗大也就罢了,这类用户往往还无法贡献收益。
如今在微博、小红书上有这样一种声音,“我们也贡献了日活、流量,DeepSeek过河拆桥”。
免费用户在传统消费互联网语境下是资产,他们贡献的注意力可以被转化为流量,再由平台卖给广告商。所以消费互联网产品的“羊毛出在猪身上,狗来买单”有一个前置条件,那就是网络效应,产品服务一万人和服务一百万人成本差不了多少,无非是多建几个机房。
可这一切在AI时代就不成立了,网络效应也不适用于AI。因为AI模型每一次回答问题、生成图片、编写代码都要消耗算力、电力、水资源,即使有KV缓存、有损上下文等优化技术,成本也是实打实的。如今的现实,是就连不缺算力且有广告的OpenAI都在不断削减免费用户的使用额度,更遑论无广告的DeepSeek了。
值得一提的是,文游、RP用户被DeepSeek重拳出击,其实对普通用户是件好事。限制长对话和单次文字输入长度,让DeepSeek在保留长上下文推理能力的同时,会降低高成本请求对算力的占用,进而提高整个系统的吞吐量。
“一鲸落,万物生”用在这里虽然不算百分百适配,却也有些道理,所以呼吁取消相关限制的用户,可能注定会大失所望。
【本文图片来自网络】